自带模型
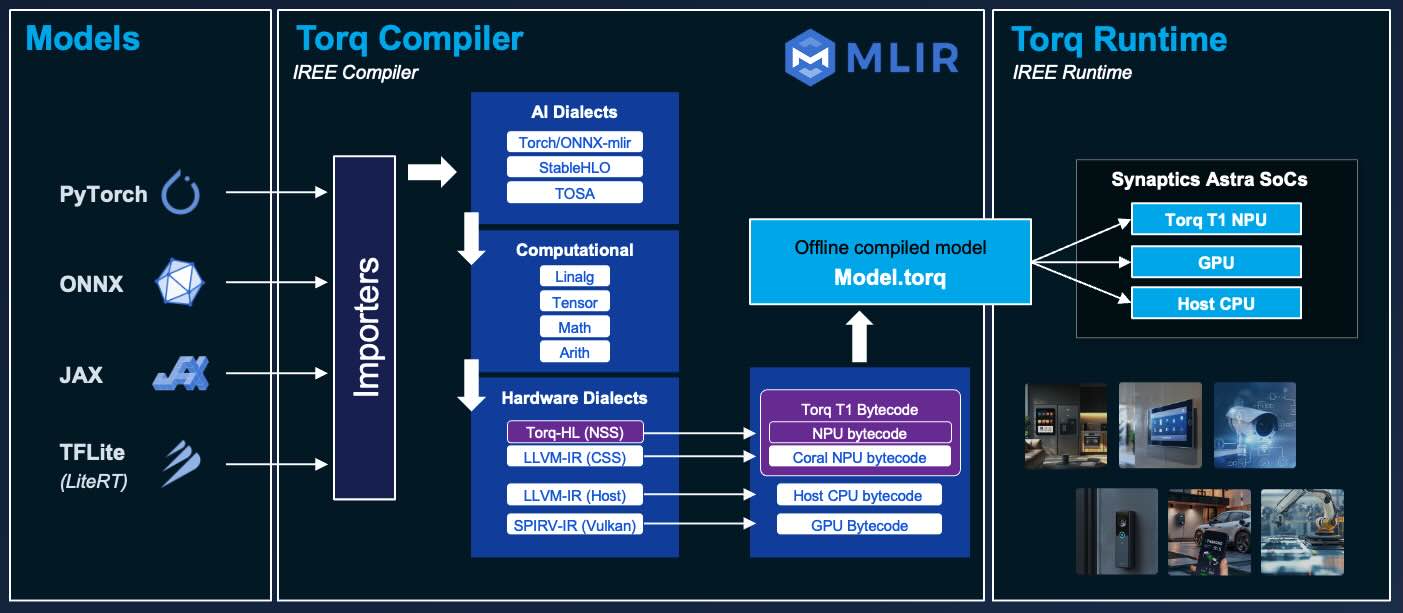
Torq 边缘 AI 平台支持执行多种神经网络,并高效利用 NPU 加速。Torq 工具链和编译器可将模型从原始格式转换为针对目标 Torq NPU 优化的表示形式。在本教程中,您将学习如何自带模型,将其优化为适用于 Synaptics Astra SL261x 处理器,并测试模型推理速度。
Torq 基于开源的 IREE/MLIR 编译器和运行时。您可以使用 C/C++ 或 Python 编写应用程序并利用 Torq NPU 加速。更多关于 Torq 的信息,请访问 Torq 编译器用户手册
查看用户章节,获取关于编译和运行模型的更多信息。
对于进阶开发者,请查看开发者章节,了解如何参与推动边缘 AI 工具民主化的行业变革。
Torq 支持运行从多种框架转换的模型,包括 TensorFlow、ONNX、PyTorch 和 JAX。
模型会被转换为针对 Torq NPU 优化运行的静态表示。在运行时,模型通过 Torq / IREE 运行时引擎执行,这是一个轻量级的预编译模型执行引擎。
提前将模型编译为优化的静态表示,比运行时翻译模型的其他方式效率更高。编译让您拥有更多控制权、更好的优化效果和更可预测的性能。
概览
环境设置
Synaptics 提供了包含必要 Torq 编译器工具和依赖项的环境包。
为简化设置并维护隔离环境,Synaptics 在 GitHub Container Registry 上提供了预构建的 Docker 镜像。
安装 Docker
登录 GitHub Container Registry
docker login ghcr.io
您需要拥有 GitHub 账号和 GitHub 个人访问令牌。
下载模型
在本教程中,您将转换一个 TFLite (LiteRT) 模型文件,并将其编译为 Torq 字节码文件格式。
请从 Hugging Face 的 Synaptics/MobileNetV2 下载 MobileNetV2_int8.tflite 文件。
运行 Docker 容器
基于镜像仓库中的 v2.0.0 Torq 开发环境 Docker 镜像,创建并运行一个临时 Docker 容器。
docker run --rm -it -v $(pwd):$(pwd) -w $(pwd) -u $(id -u):$(id -g) ghcr.io/synaptics-torq/torq-compiler/compiler:v2.0
将模型转换为 MLIR 方言
在编译之前,需要将模型表示为 MLIR 支持的方言。
在本教程中,我们将重点使用一种常用方言——张量算子集架构(TOSA)。
TOSA 方言的 MLIR 文件可以是文本格式(.tosa 或 .mlir)或二进制格式(.mlirbc)。我们将使用文本格式。
在 Docker 容器运行状态下,执行此命令:
tosa-converter-for-tflite MobileNetV2_int8.tflite --text -o MobileNetV2_int8.tosa
如果成功,您将看到类似以下的输出:
[INFO] TOSA MLIR (text) written to: synaptics_MobileNetV2.tosa
从 Torq 编译器 2.0.0 版本开始,推荐使用 tosa-converter-for-tflite 工具转换 TensorFlow Lite 文件,因为它生成的表示更加标准化,并且可跨平台运行。本教程的早期版本使用的是 iree-import-tflite 工具。作为参考,之前的命令仍然可用。
iree-import-tflite MobileNetv2_int8.tflite -o MobileNetv2_int8.tosa
将模型编译为 Torq 字节码格式
使用以下命令编译模型:
torq-compile MobileNetv2_int8.tosa -o MobileNetv2_int8.vmfb
如果成功,您将看到类似以下的输出:
[TORQ] Lowering dispatch: main_dispatch_0_conv_2d_nhwc_hwcf_1x7x7x1280x1x1x320_i8xi8xi32
Torq 编译器有很多选项。要获取完整列表,请输入此命令:
torq-compile -h
编译器的输出将是一个 MobileNetv2_int8.vmfb 文件,这是一个存储 Torq 字节码的 Virtual Machine FlatBuffer (VMFB) 文件。
退出 Docker 容器
exit
将模型上传到 Astra SL2610 开发板
现在您可以在终端中使用 adb 或 ssh 将其上传到 SL2610 系列开发套件。
例如,使用 adb:
adb push MobileNetv2_int8.vmfb /home/root/
测试模型
在 Astra 设备上打开终端。如果您连接了显示器、鼠标和键盘,可以直接使用。
您也可以从开发机器使用 adb 或 ssh 连接。这里我们使用 adb。
adb shell
在 Astra 的命令提示符中,使用虚拟数据运行模型:
cd /home/root
iree-run-module --device=torq --module=MobileNetv2_int8.vmfb --function=main --input="1x224x224x3xi8=1"
您将看到以下开头的输出,表明模型运行正确:
1x1000xi8=[-128 -128 -128 -128 -128 -128 -128 -128 -128 -128 …
您也可以使用 sl2610-examples 这个基于 Python 的示例应用仓库中的 image_classification 示例应用来测试该模型。
此外,您还可以在 torq_examples 仓库中查看在 Torq 上运行模型的其他示例应用。
新功能 - 使用 Torq 编译器 Python 包!(目前仅支持 x86)
从 Torq 编译器 2.0.0 版本开始,提供了包含编译器和工具的 Python 包。这样便无需再使用 Docker。
从 v2.0.0 起,该包含的工具可转换以下框架的模型:
- TensorFlow Lite
- ONNX
- TensorFlow SavedModel
主机要求
- Python 3.12
- 目前仅支持运行 Linux 的 x86 主机(包括 Windows 上的 WSL)
操作步骤
在 Torq 编译器发布页面打开最新的发布版本。
在 Assets 中找到并下载 torq_compiler 的 .whl 文件(例如 torq_compiler-2.0.0-cp312-cp312-manylinux_2_28_x86_64.whl)。
在您的主机上打开终端,例如 Windows 上的 WSL。
创建并激活 Python 虚拟环境。
python3 -m venv .venv
source .venv/bin/activate
安装该包,并传入 onnx 和 tflite 标志以启用对这些框架的转换支持。
pip install "torq_compiler-<version>-<platform>.whl[onnx,tflite]"
使用随附的 tosa-converter-for-tflite 工具转换模型。
tosa-converter-for-tflite MobileNetv2_int8.tflite --text -o MobileNetv2_int8.tosa
使用以下命令编译模型:
torq-compile MobileNetv2_int8.tosa -o MobileNetv2_int8.vmfb
恭喜
您已成功从 Hugging Face 导入模型,针对 Torq NPU 进行优化,并在 Synaptics Astra SL2619 上运行!
查看图像分类快速指南,了解如何运行它。
附加信息
如果您使用的是 Apple Silicon 的 macOS,在使用本教程中提及的 iree-import-tflite 工具时,可能会遇到 无效指令 错误。
使用 linux/arm64 平台类型构建 Docker 镜像,按照以下步骤操作:
- 下载最新的发布包。
- 解压文件:
tar -xvzf release.tar.gz
cd release
- 使用
linux/arm64平台类型构建 Docker 镜像:
docker build --platform linux/arm64 -t synaptics-torq/torq-compiler/compiler-arm64:latest .
- 创建并运行用于模型转换的容器:
docker run --rm --platform linux/arm64 -it -v $(pwd):$(pwd) -w $(pwd) -u $(id -u):$(id -g) synaptics-torq/torq-compiler/compiler-arm64
仅在运行 iree-import-tflite 命令时使用此容器。