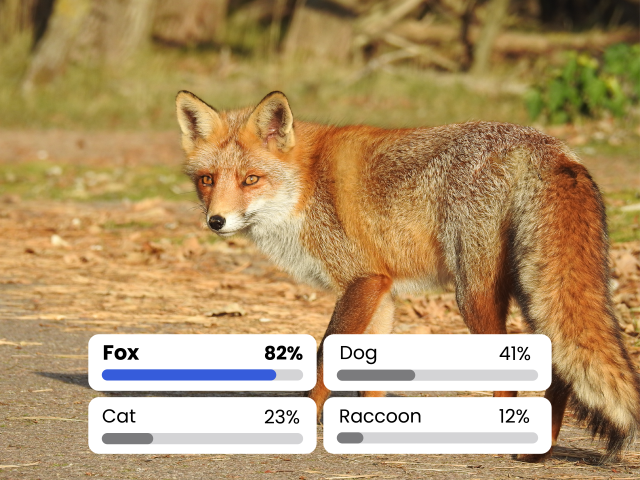
Inception V4 299 量化版
专为 ImageNet 299x299 分辨率图像分类任务优化的量化 Inception V4 模型。
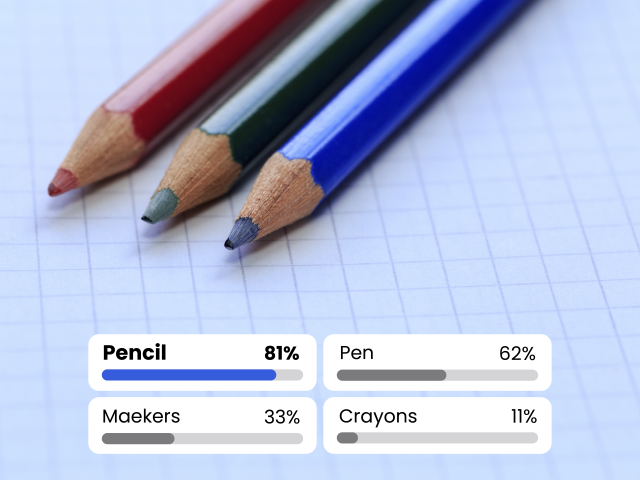
MobileNet V1 0.25 224 浮点版
带有 0.25 宽度乘数的 MobileNet V1 模型,专为 ImageNet 224x224 分辨率图像分类任务优化。
MobileNet V1 0.25 224 量化版
带有 0.25 宽度乘数的量化 MobileNet V1 模型,专为 ImageNet 224x224 分辨率图像分类任务优化。
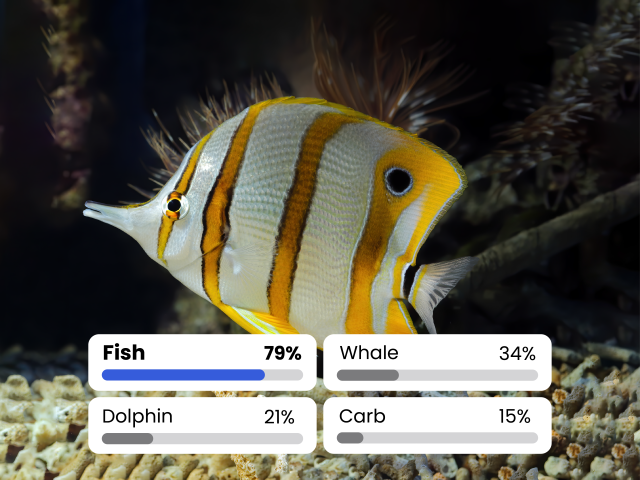
MobileNet V2 1.0 224 浮点版
带有 1.0 宽度乘数的 MobileNet V2 模型,专为 ImageNet 224x224 分辨率图像分类任务优化。
MobileNet V2 1.0 224 量化版
带有 1.0 宽度乘数的量化 MobileNet V2 模型,专为 ImageNet 224x224 分辨率图像分类任务优化。
NV12@1920x1080 转 RGB@1920x1080
将 NV12 格式的 1920x1080 图像转换为同分辨率 RGB 格式的预处理模型。
NV12@1920x1080 转 RGB@224x224
将 NV12 格式的 1920x1080 图像转换为 224x224 分辨率 RGB 格式的预处理模型。
NV12@1920x1080 转 RGB@640x360
将 NV12 格式的 1920x1080 图像转换为 640x360 分辨率 RGB 格式的预处理模型。
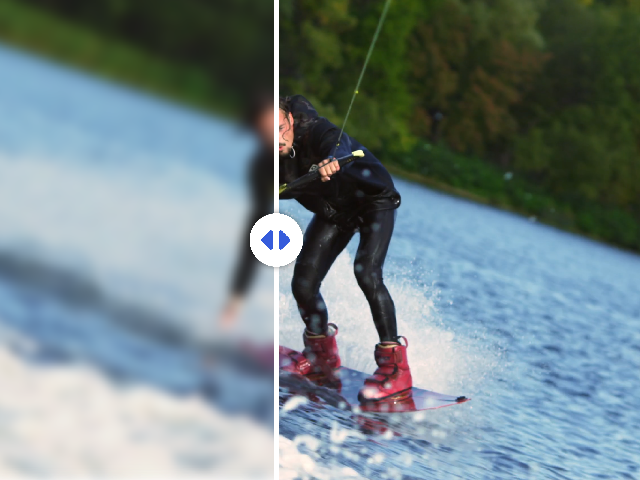
SR Fast Y UV 1280x720 至 3840x2160
将 YUV 图像从 1280x720 转换至 3840x2160 分辨率的快速超分辨率模型。
SR Fast Y UV 1920x1080 至 3840x2160
将 YUV 图像从 1920x1080 转换至 3840x2160 分辨率的快速超分辨率模型。
SR QDEO Y UV 1280x720 至 3840x2160
基于 QDEO 的超分辨率模型,将 YUV 图像从 1280x720 转换至 3840x2160 分辨率。
SR QDEO Y UV 1920x1080 至 3840x2160
基于 QDEO 的超分辨率模型,将 YUV 图像从 1920x1080 转换至 3840x2160 分辨率。
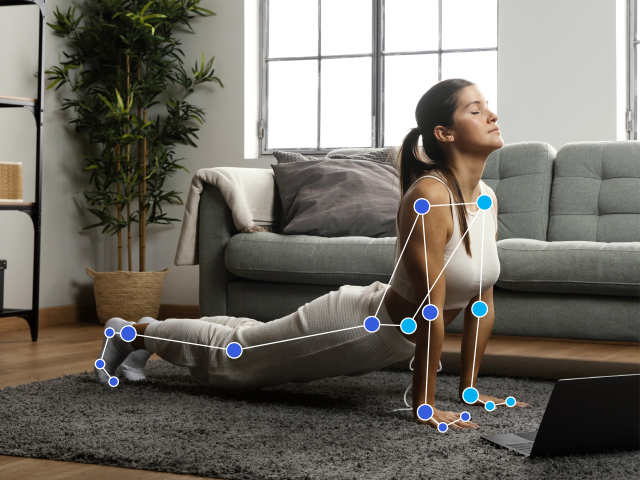
PoseNet MobileNet 0.75 浮点版
采用 MobileNet 架构、75% 宽度乘数的 PoseNet 模型,用于高效人体姿态估计。
PoseNet MobileNet 0.75 量化版
采用 MobileNet 架构、75% 宽度乘数的量化 PoseNet 模型,用于高效优化的人体姿态估计。
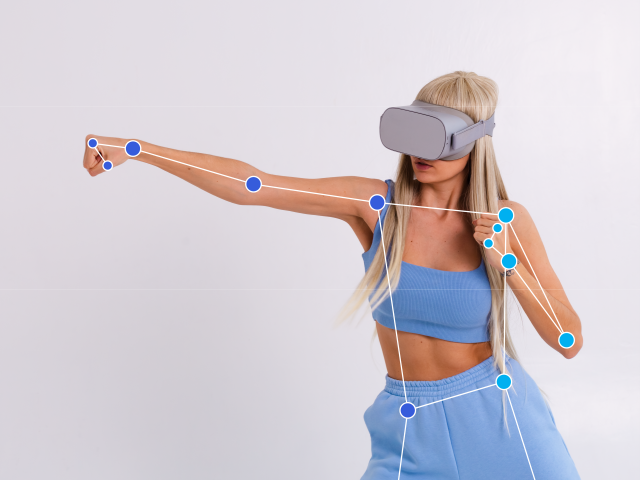
YOLOv8s 姿态版
专为人体姿态估计设计的 YOLOv8s 模型,针对实时应用场景进行了优化。
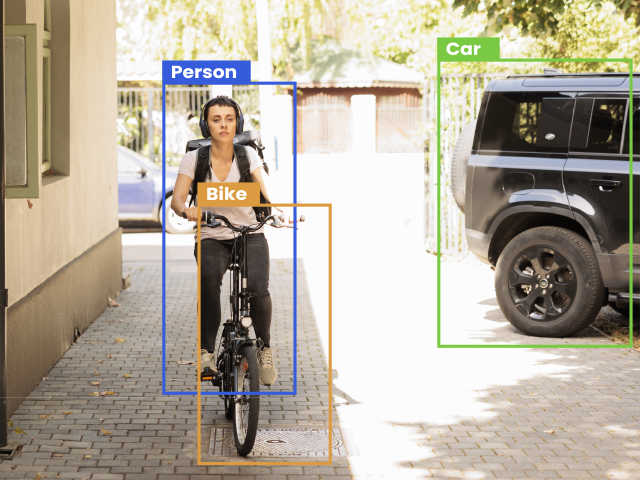
MobileNet224 Full80
针对 COCO 数据集目标检测优化的 MobileNet 模型,支持 224x224 全分辨率及 80 个类别。
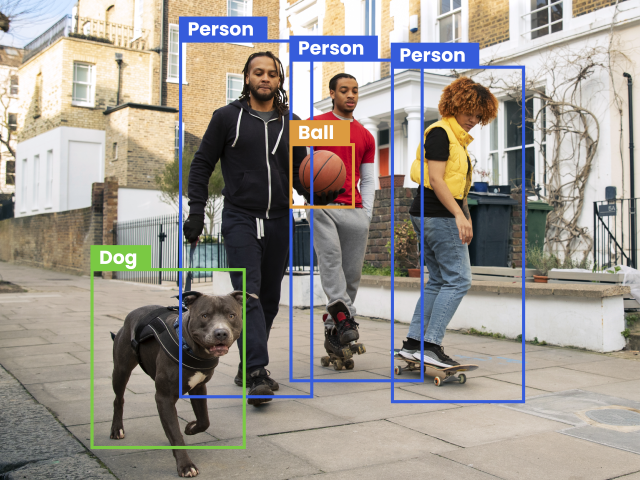
YOLOv5m 640x480
针对 640x480 分辨率优化的 YOLOv5m 目标检测模型,在速度与精度之间取得平衡。
YOLOv5s 640x480
针对 640x480 分辨率优化的 YOLOv5s 目标检测模型,适用于实时应用场景。
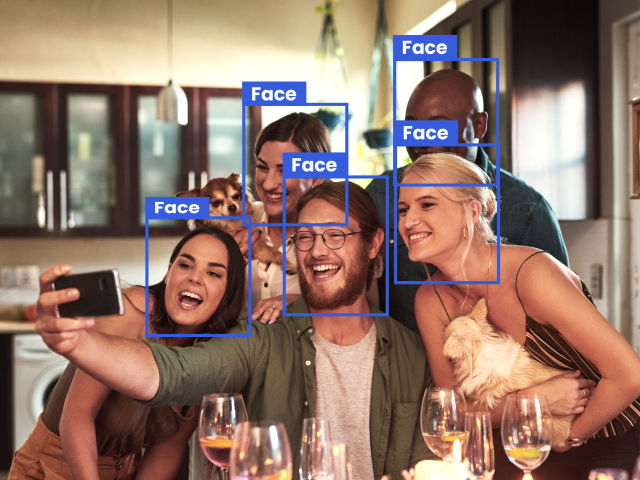
YOLOv5s 人脸检测 640x480 ONNX MQ
专为人脸检测设计的 YOLOv5s 模型,针对 640x480 分辨率优化,采用 ONNX 混合量化。
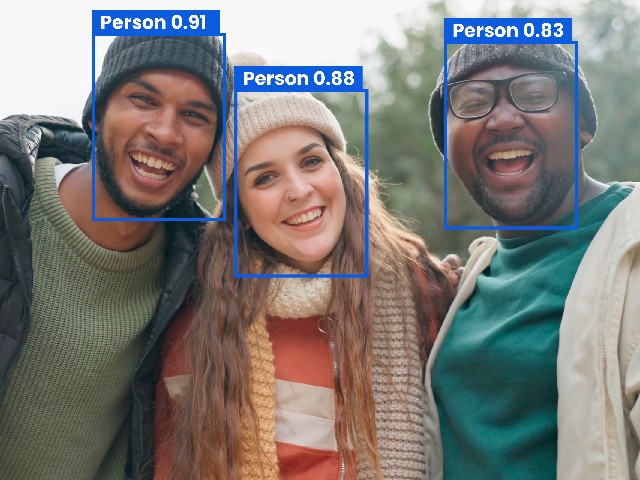
MobileNet224 Full1
针对高分辨率图像中人员检测优化的轻量级 MobileNet 模型。
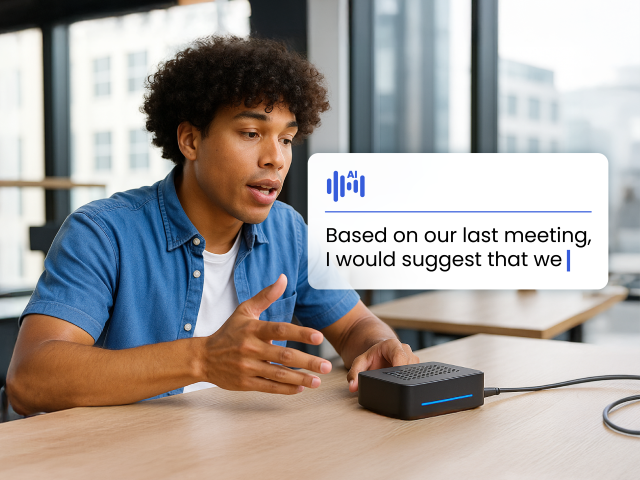
Moonshine Streaming Tiny
流式自动语音识别模型,采用滑动窗口编码器以缩短首 token 时间,针对 16kHz 单声道音频优化。
Moonshine Tiny BF16
专为实时语音识别设计的高效自动语音识别模型,采用可变长度架构,支持最长 30 秒的 16kHz 单声道音频输入。
Face ID INT8
三阶段设备端人脸识别流水线:人脸检测、68 点面部关键点和 256 维人脸特征向量。
MobileNet V2 224x224 INT8
针对 ImageNet 224x224 分辨率图像分类任务优化的量化 MobileNet V2 模型,采用 1.0 宽度乘数。
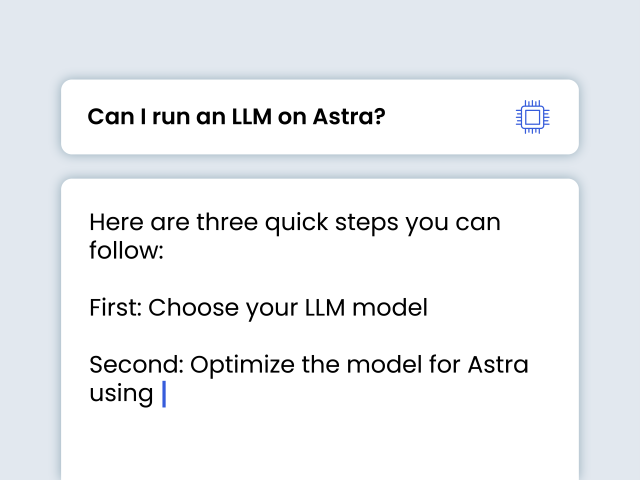
Gemma3 270M IT INT4
Google 推出的紧凑型 2.7 亿参数语言模型,量化为 INT4,适用于文本分类和数据提取任务,并支持快速微调。
Gemma3 270M IT
Google 推出的轻量级 2.7 亿参数多模态语言模型,专为文本分类和数据提取等任务优化,具备快速微调能力。
LiquidAI LFM2.5 230M BF16
Liquid AI 推出的 2.3 亿参数混合短卷积与注意力语言模型,可作为技能选择层,将指令分解为工具调用。
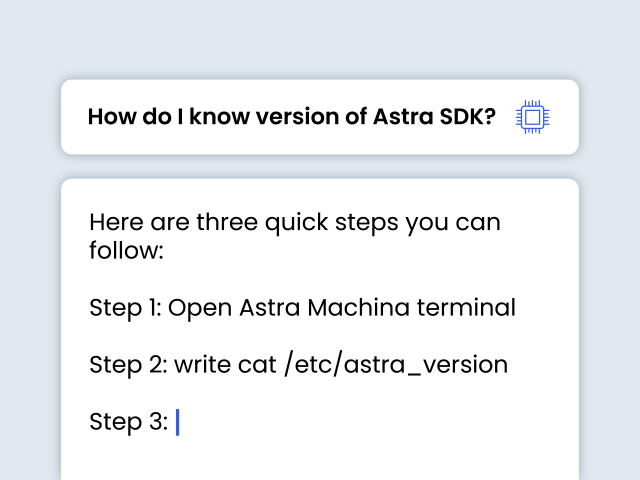
LiquidAI LFM2-VL 450M BF16
Liquid AI 推出的 4.5 亿参数视觉语言模型,可回答与输入图像相关的自然语言问题。
YOLOv8n Pose Nano 320x320 INT8
针对 320x320 分辨率优化的 YOLOv8n 姿态估计模型,可检测人体及其身体关键点。
YOLOv8s Pose Small 320x320 INT8
针对 320x320 分辨率优化的 YOLOv8s 姿态估计模型,可检测人体及其身体关键点。
YOLOv8n Nano 320x320 INT8
针对 320x320 分辨率优化的 YOLOv8n 目标检测模型,在速度与精度之间实现平衡。
YOLOv8s Small 320x320 INT8
针对 320x320 分辨率优化的 YOLOv8s 目标检测模型,在速度与精度之间实现平衡。
YOLO26 320x320 INT8
YOLO26 免 NMS 目标检测模型(nano 和 small),针对 320x320 分辨率优化,解码头已编译至 NPU。
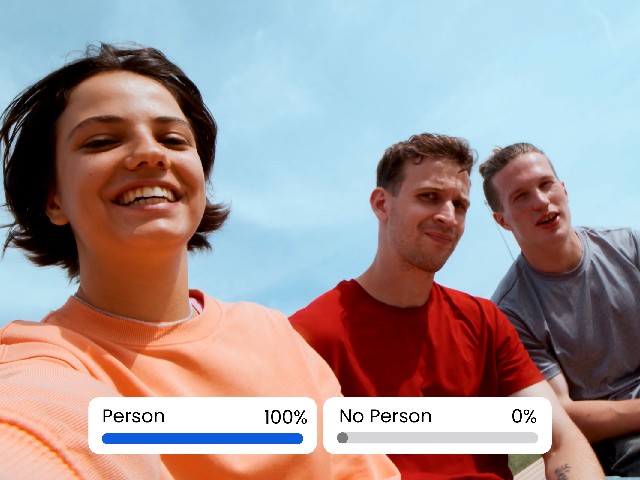
人员分类 256x448(SR100 系列)
由 Synaptics 开发的 256x448 人员分类模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人员分类 448x640(SR100 系列)
由 Synaptics 开发的 448x640 人员分类模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
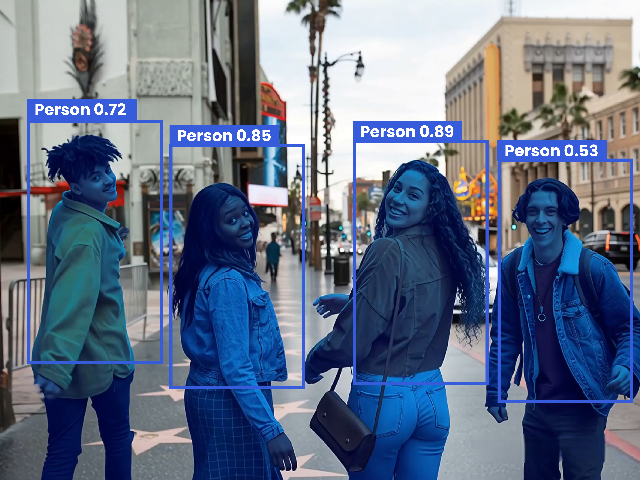
人员检测 256x480(SR100 系列)
由 Synaptics 开发的 256x480 人员检测模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人员检测 480x640(SR100 系列)
由 Synaptics 开发的 480x640 人员检测模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人体姿态检测 256x480(SR100 系列)
由 Synaptics 开发的 256x480 人体姿态检测模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人体姿态检测 480x640(SR100 系列)
由 Synaptics 开发的 480x640 人体姿态检测模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人体分割 256x480(SR100 系列)
由 Synaptics 开发的 256x480 人体分割模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。
人体分割 480x640(SR100 系列)
由 Synaptics 开发的 480x640 人体分割模型,是专为 SR100 处理器设计的轻量级量化 `tflite` 模型。