
在 SL2610 系列上实现函数调用
请先完成 SL2610 入门指南。该指南涵盖开发板配置、克隆示例仓库以及创建 Python 环境。每打开一个新终端,都需要运行 source .venv/bin/activate 激活环境。
函数调用(Function Calling)让语言模型能够将自然语言请求转换为对工具的结构化调用,从而让软件和硬件据此执行操作。模型不再以文本回复,而是决定运行哪个函数以及使用哪些参数。
在本指南中,您将完全在开发板上运行 FunctionGemma 270M,该模型经过微调,可控制 Coralboard 传感器扩展板上的指示灯和蜂鸣器。无需云端、无需 API 密钥,也无需唤醒词。说出或输入"turn the red light on"(打开红灯),开发板即可在约 1.3 至 2 秒内完成操作。
FunctionGemma 与功能 token
FunctionGemma 是 Google 推出的基于 Gemma 的小型模型,用于工具路由。本演示所用版本采用 Octopus v2 风格进行微调:每个工具都是固化在模型权重中的单个 token,因此提示词中无需包含工具定义(schema)。设备端提示词仅约 13 个 token,使得在双核 Cortex-A55 CPU 上的预填充(prefill)阶段保持快速。
一个紧凑的编解码器会将模型输出(例如 <tool_0>(color="red", state="on")<end>)还原为工具调用,再由分发器在硬件上执行。
| 工具 | 功能 |
|---|---|
set_lights | 设置传感器扩展板状态 LED 或可选 WLED Neopixel 灯环的颜色、效果或开关状态 |
play_buzzer | 播放指定模式(beep、double_beep、chirp、siren、alarm、success、error) |
set_alarm / cancel_alarm | 设置或取消闹钟 |
get_system_status | 报告 CPU、内存、温度或 NPU 状态 |
respond | 当没有合适的操作时,以自然语言回复 |
语音输入为可选功能。启用后,Silero VAD 负责检测语音,Moonshine 在 Torq NPU 上完成语音转写,因此语音识别与 LLM 不会争用同样的两个 CPU 核心。
在 Astra 上运行函数调用
硬件
- Synaptics Coralboard(SL2619)及 Grinn Coralboard 传感器扩展板(RGB 状态 LED 和压电蜂鸣器)
- 可选:麦克风(传感器扩展板上的 PDM 麦克风或任意 USB 麦克风),用于语音输入
- 可选:运行 WLED 固件的 Adafruit Sparkle Motion Mini(6314)和 48 像素 WS2812B 灯环(2539),通过 USB 连接,用于 Neopixel 灯光效果
安装该示例所需的依赖并下载模型:
cd Function_calling
pip install -r requirements.txt
python setup_demo.py
不同示例需要不同版本的 Python Torq 运行时。如果多个示例共用一个虚拟环境,每次切换示例时,请在对应示例文件夹中重新运行 pip install -r requirements.txt。
如需语音输入,还需一次性安装 PortAudio 系统库:
../setup/install_portaudio.sh
在边缘侧运行函数调用
运行命令行版本
python3 run_cli.py
模型加载约需 3.5 秒,随后会出现提示符。试试以下命令:
>>> Turn the red light on
  set_lights: color=red state=on
  (1 tool call · 1821 ms)

>>> Play a siren
  play_buzzer: pattern=siren
  (1 tool call · 1374 ms)

>>> How much memory is free?
  get_system_status: {'memory': 38.4}
  (1 tool call · 1355 ms)
运行单条提示词后退出:
python3 run_cli.py --prompt "Turn the red light on"
每条提示词只包含一个操作。270M 模型只会输出一次工具调用,因此"beep twice and flash the green LED"(蜂鸣两次并闪烁绿灯)只会执行其中一个操作。
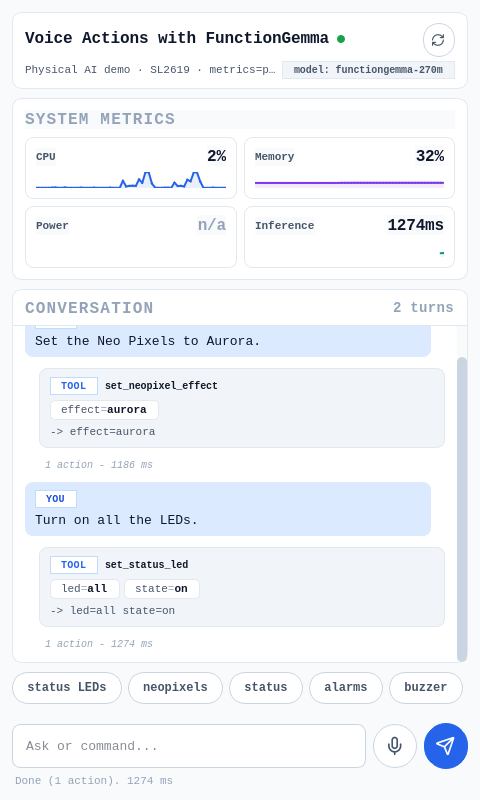
运行图形界面
按照入门指南配置显示环境(XDG_RUNTIME_DIR 和 WAYLAND_DISPLAY),并添加 Qt 相关变量:
export QT_QPA_PLATFORM=wayland
export WESTON_DISABLE_GBM_MODIFIERS=true
如需在 800x480 显示屏上使用竖屏模式:
export ORIENTATION=portrait
export DISPLAY_HEIGHT=800
export DISPLAY_WIDTH=480
然后启动 PyQt 应用:
python3 run_gui.py
添加 --fullscreen 可铺满 7 英寸屏幕。按 Esc 退出。
添加语音输入
python3 run_gui.py --voice moonshine
界面上会显示 Mic 按钮。如果已插入 USB 麦克风,可使用 --mic 0 固定使用传感器扩展板麦克风,或使用 --mic USB 选择 USB 麦克风。在启用真实语音模型之前,可使用 --voice stub 以预设短语测试麦克风链路。
添加 Neopixel 灯光(可选)
插入 Sparkle Motion,并确认其显示为串口设备:
ls /dev/ttyACM*
python3 run_cli.py
程序会自动检测第一个 /dev/ttyACM* 设备,并将 set_lights 命令发送到灯环。未连接灯环时,这些命令将改为驱动传感器扩展板上的三个 LED。使用 --wled-port /dev/ttyACM1 可指定特定设备,使用 --no-wled 可强制仅使用传感器扩展板。
开机自动启动
bash scripts/install-service.sh
该脚本会安装一个 systemd 服务:等待 Weston 启动、设置显示变量,并以全屏方式运行图形界面。使用 journalctl -u functiongemma-demo -f 查看其日志。
可以尝试的其他选项
--model:指定其他 GGUF 模型的路径--voice {off,stub,moonshine}:语音输入模式--mic:麦克风设备索引或名称子串--wled-port、--no-wled、--wled-baud:Neopixel 串口设置--fullscreen:全屏显示(仅限图形界面)
模型
本教程使用以下预编译模型(适用于 SL2610 系列)。有关详细信息、性能数据和下载链接,请参阅模型页面:
可前往模型页面浏览所有模型。
Python 代码解析
各模块体积小且职责分明。查看以下文件以了解更多:
llamacpp.py:封装 llama.cpp,加载 GGUF 模型并执行生成compact_codec.py:将<tool_N>(args)<end>解析为工具调用dispatcher.py:根据tools.json校验参数,并调用hardware.py中对应的方法lights.py:根据所连接的设备,将set_lights路由到传感器扩展板 LED 或 WLED 灯环
应用启动时还会将 CPU 调频策略切换为 performance(cpu_governor.py)。OOBE 镜像上默认的调频策略为 schedutil,可能使首次响应变慢约 3 倍。