
视觉语言模型:在 SL2610 系列上进行场景描述
请先完成 SL2610 入门指南。该指南介绍了如何配置开发板、克隆示例仓库以及创建 Python 环境。在每个新终端中,使用 source .venv/bin/activate 激活该环境。
视觉语言模型(VLM)能够同时理解图像和文本。您向它提供一张图片和一段提示词,它会用自然语言作答。这使设备能够描述场景、回答有关照片的问题或识读眼前的内容,而无需像图像分类或目标检测那样依赖固定的标签列表。
在本指南中,您按下快门按钮,开发板拍摄一张照片,然后由 LiquidAI LFM2-VL-450M 对其进行描述。视觉编码器和解码器均以 bf16 精度在 Torq NPU 上运行。
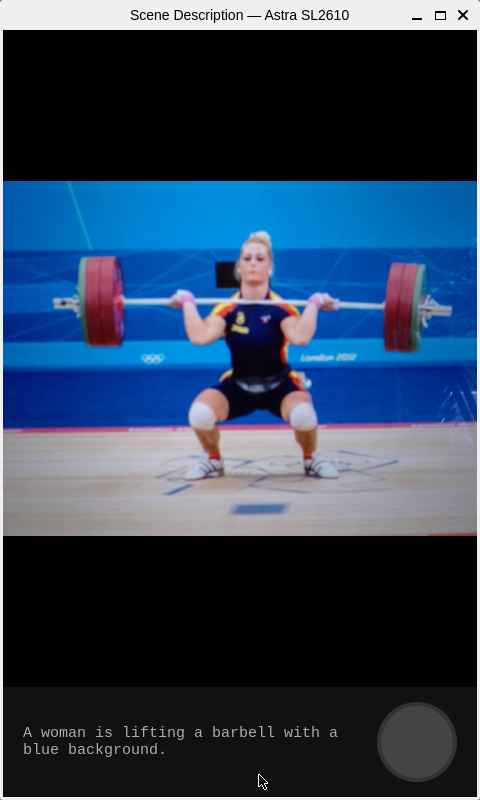
在 Astra 上运行场景描述
硬件
- Astra Machina SL2610 开发套件或 Synaptics Coralboard
- 一个摄像头:USB(UVC)摄像头或 MIPI CSI 摄像头,例如 Coralboard 传感器扩展板上的 OV5647
- 一块用于 GUI 的显示屏,例如 7 英寸 Waveshare 触摸屏(CLI 无需显示屏即可运行)
安装本示例专用的依赖项并下载模型:
cd scene_description
pip install -r requirements.txt
python setup_demo.py
模型文件存储在 models/Synaptics/LiquidAI-LFM2-VL-450M/ 中。
边缘端场景描述
无显示屏运行
run_cli.py 会拍摄一张照片并在终端中打印描述。照片保存为 scene_capture.jpg。
python3 run_cli.py
也可以不使用摄像头,而是描述一张现有图片:
python3 run_cli.py --image ../samples/dog_bike_car.jpg
运行 GUI
按照入门指南配置显示环境。若要在 800x480 显示屏上使用竖屏模式,请从仓库根目录运行共享的配置脚本(参见仓库 README 中的 Device Configuration 部分):
./setup/portrait_setup.sh
然后在 scene_description 文件夹中启动应用:
python3 run_gui.py
按下快门按钮拍摄图像。照片和提示词会被发送到 NPU 上的 VLM,描述生成后即会显示。
摄像头
USB 摄像头支持自动曝光,因此直接使用即可。MIPI CSI 摄像头没有可用的自动曝光功能,在默认增益下会输出黑帧,因此应用会在打开摄像头时(约一秒)设置曝光和白平衡,并根据图像亮度调整增益。如果两种摄像头同时连接,auto 会优先使用 USB 摄像头。传入 --camera-device /dev/video0 可使用 CSI 摄像头。
默认情况下图像不会旋转。如果图像上下颠倒,请添加 --rotate 180。
更多可尝试的选项
--camera-device:设备,例如/dev/video0,或auto(默认)--rotate {0,90,180,270}:将摄像头画面顺时针旋转--prompt:发送给 VLM 的问题。默认为 "Describe this image in two sentences."--models:存放 LFM2-VL-450M 文件的文件夹--no-refresh:离线运行时跳过 Hugging Face 更新检查
尝试提出一个更具体的问题:
python3 run_gui.py --prompt "What is the main object in this photo, and what color is it?"
模型
本教程使用以下预编译模型(适用于 SL2610 系列)。有关详细信息、性能数据和下载链接,请参阅模型页面:
可前往模型页面浏览所有模型。
Python 代码解析
VLM 封装类(LFM2VL)从仓库 Torq 示例中的 LiquidAI/LiquidAI-LFM2-VL-450M 示例导入。run_gui.py 使用 app_utils.camera 打开摄像头、旋转画面、保存拍摄的图像,并将图像和提示词传递给模型。NPU 在推理前完成准备,并在退出时释放。
查看 scene_description/run_gui.py 和 run_cli.py 以了解更多信息。